Un garde-fou peut bloquer une sortie dangereuse. Une gouvernance définit l'architecture complète qui dit ce qu'un agent peut faire, quand il peut le faire, qui doit approuver, comment l'arrêter et comment prouver ce qui s'est passé.
Quand une organisation pilote plusieurs agents IA, la question n'est plus seulement de filtrer les réponses. Il faut classer les actions, gérer les escalades, tester les systèmes de sécurité et mesurer la dette de contrôle avant qu'elle ne devienne un incident.
Pourquoi la gouvernance compte
La plupart des projets IA commencent par des capacités: connecter un modèle, brancher quelques outils, automatiser une tâche. La gouvernance arrive ensuite, souvent quand le système commence déjà à produire des décisions difficiles à expliquer.
Cette approche fonctionne en démonstration, mais pas en production. Une flotte d'agents peut déclencher des communications, consommer du budget, lire des données sensibles, modifier des états métier ou prendre des décisions qui doivent rester sous contrôle humain.
La gouvernance doit répondre tôt à trois questions: quelles actions sont autorisées, quelles actions doivent être signalées, et quelles actions doivent rester bloquées jusqu'à validation.
Le système de classification en trois tiers
Une gouvernance utilisable doit rester simple. Trois niveaux suffisent pour créer une première architecture exploitable: exécution automatique, notification, validation obligatoire.
Tier 1: exécution automatique
Le premier niveau couvre les opérations routinières, faibles risques et réversibles. L'agent peut agir directement, mais l'action reste journalisée.
Ce niveau est nécessaire pour garder la vitesse des agents. Si chaque micro-action attend une validation humaine, le système perd l'essentiel de son intérêt opérationnel.
- Lectures de données autorisées.
- Mises à jour de statut sans conséquence externe.
- Analyses internes faibles risques.
- Transactions ou consommations très faibles sous seuil défini.
- Tâches répétitives déjà validées par le cadre de gouvernance.
Tier 2: notification
Le deuxième niveau concerne les actions à risque modéré. L'agent peut agir, mais la supervision doit être informée.
Ce niveau évite de bloquer les opérations tout en donnant de la visibilité sur les décisions qui méritent une surveillance.
- Communications externes non sensibles.
- Actions financières au-dessus d'un seuil faible, mais sous le seuil critique.
- Utilisation d'outils autorisés dans un contexte nouveau.
- Actions qui modifient une file de travail ou une priorité.
- Décisions qui doivent apparaître dans le tableau de bord de supervision.
Tier 3: blocage jusqu'à approbation
Le troisième niveau couvre les actions qui ne doivent pas être déléguées à l'agent seul. Le système bloque l'exécution et crée une demande d'approbation.
Ce mécanisme transforme la validation humaine en partie native du flux, au lieu d'en faire une intervention manuelle hors système.
- Accès à un nouvel outil ou à un nouveau domaine.
- Changement de permissions ou d'identifiants.
- Transaction financière importante.
- Communication externe sensible ou engageante.
- Décision qui modifie une politique, un budget ou une règle de gouvernance.
Des tiers configurables, pas des règles figées
Les règles fixes deviennent vite fausses. Une action peut être faible risque pour un agent, mais critique pour un autre. Elle peut être acceptable en journée, mais nécessiter une validation après les heures ouvrées.
La classification doit donc être ajustable par agent, par période, par état opérationnel et par niveau de risque.
- Par agent: un agent finance n'a pas les mêmes seuils qu'un agent recherche.
- Par temps: certaines actions peuvent être plus strictes la nuit ou le week-end.
- Par état opérationnel: incident, alerte ou crise doivent durcir les règles.
- Par niveau de risque: le contexte peut faire monter une action de T1 à T2 ou T3.
- Par domaine: finance, sécurité, communication et données sensibles nécessitent des seuils différents.
Les cinq coupe-circuits de gouvernance
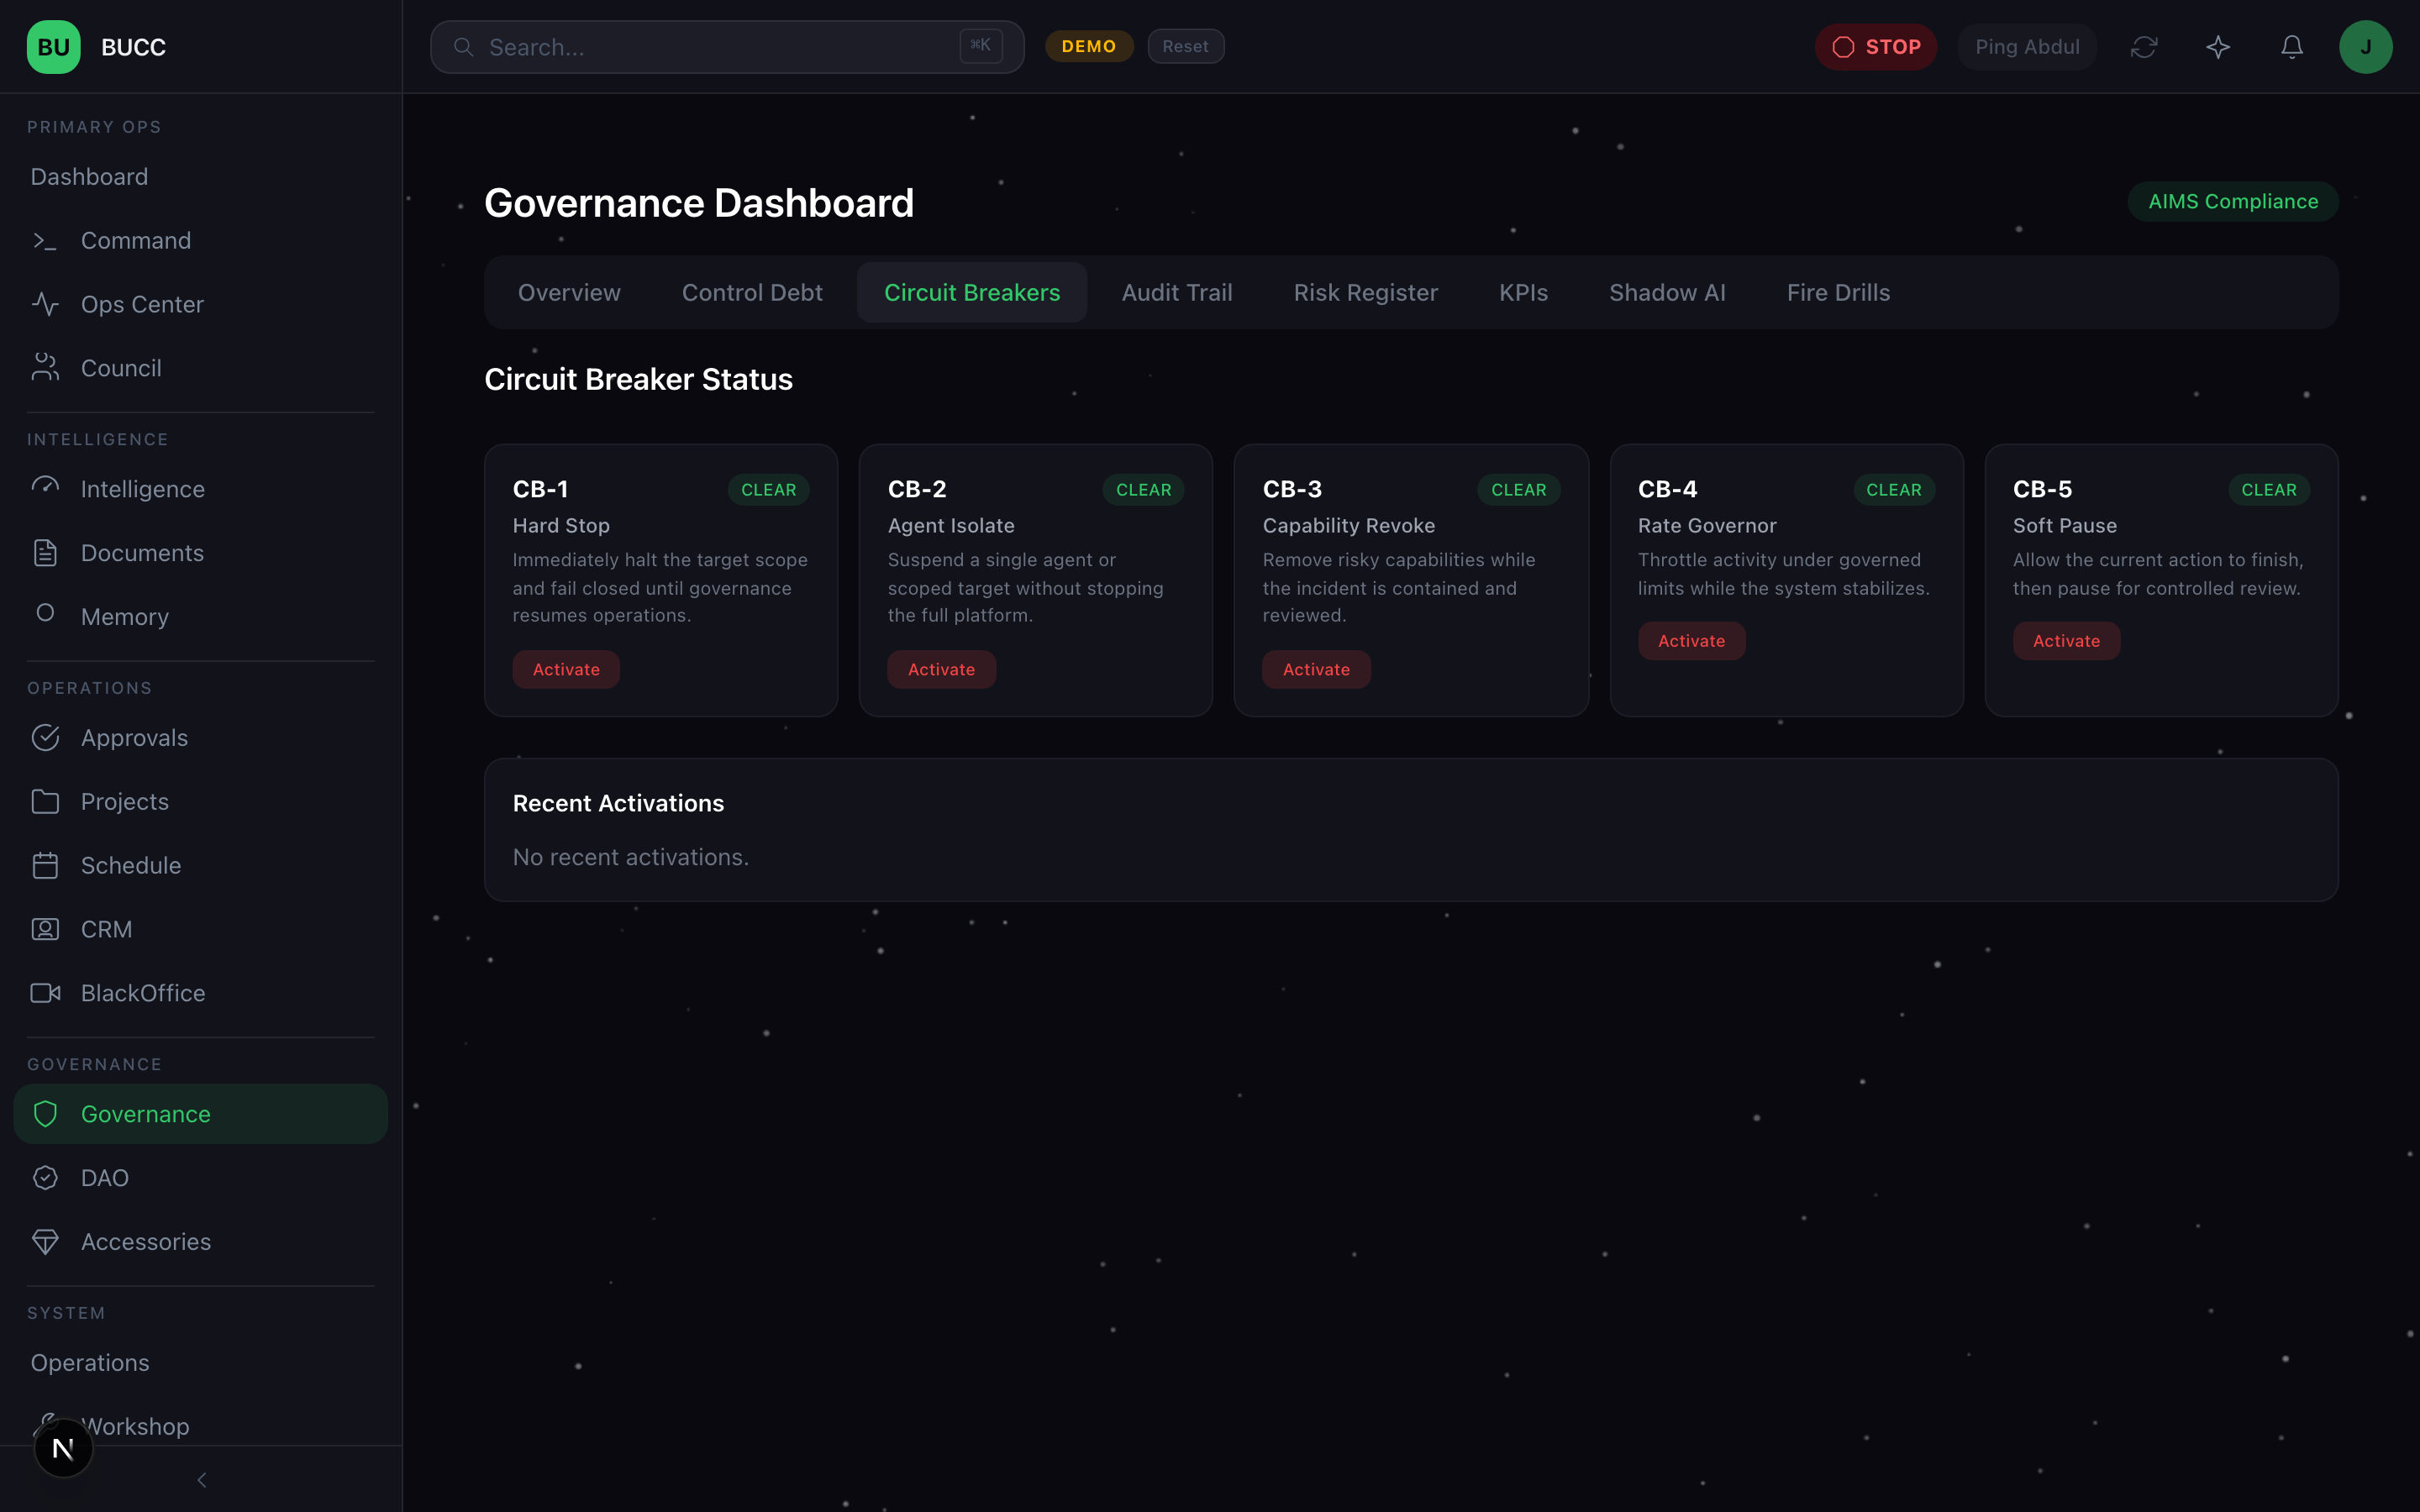
Les coupe-circuits servent à limiter progressivement une flotte d'agents sans devoir tout reconstruire pendant un incident. Ils donnent une réponse immédiate et graduée selon la nature du risque.
Coupe-circuit 1: hard stop
Le hard stop est l'arrêt d'urgence. Il coupe tous les agents, tous les travaux en cours et tous les appels externes.
Ce bouton doit être simple, visible et testé. Un mécanisme d'arrêt que personne n'ose utiliser ou que personne n'a jamais testé n'est pas un contrôle fiable.
Coupe-circuit 2: enforcement gouvernance
Ce mode restreint la flotte aux actions T1. Les actions T2 et T3 sont bloquées ou mises en attente.
Il est utile quand l'organisation veut continuer les opérations faibles risques tout en empêchant les décisions plus engageantes.
Coupe-circuit 3: pause financière
La pause financière bloque les transactions, paiements, consommations ou opérations qui peuvent avoir un impact budgétaire significatif.
Elle permet de répondre rapidement à une anomalie de dépense, une erreur de routage ou un comportement agentique inattendu.
Coupe-circuit 4: pause communications
La pause communications bloque les messages sortants, notifications externes, emails ou publications qui pourraient engager l'organisation.
Ce mode protège contre les erreurs de ton, les fuites d'information, les communications prématurées et les décisions externes non validées.
Coupe-circuit 5: alerte douce
L'alerte douce ne bloque pas nécessairement les opérations. Elle augmente la surveillance, abaisse les seuils d'approbation et rend la supervision plus attentive.
C'est un mode jaune: le système continue de fonctionner, mais avec moins d'autonomie et plus de visibilité.
Comment les coupe-circuits se combinent
Les coupe-circuits doivent être hiérarchisés. Un hard stop dépasse tous les autres contrôles. Une pause financière ne doit pas bloquer les opérations non financières. Une alerte douce peut coexister avec d'autres restrictions.
Cette logique de cascade évite les conflits de règles et permet à l'organisation de réagir précisément: arrêter tout, limiter certains domaines, ou simplement augmenter le niveau d'observation.
La file d'approbation: la décision humaine structurée
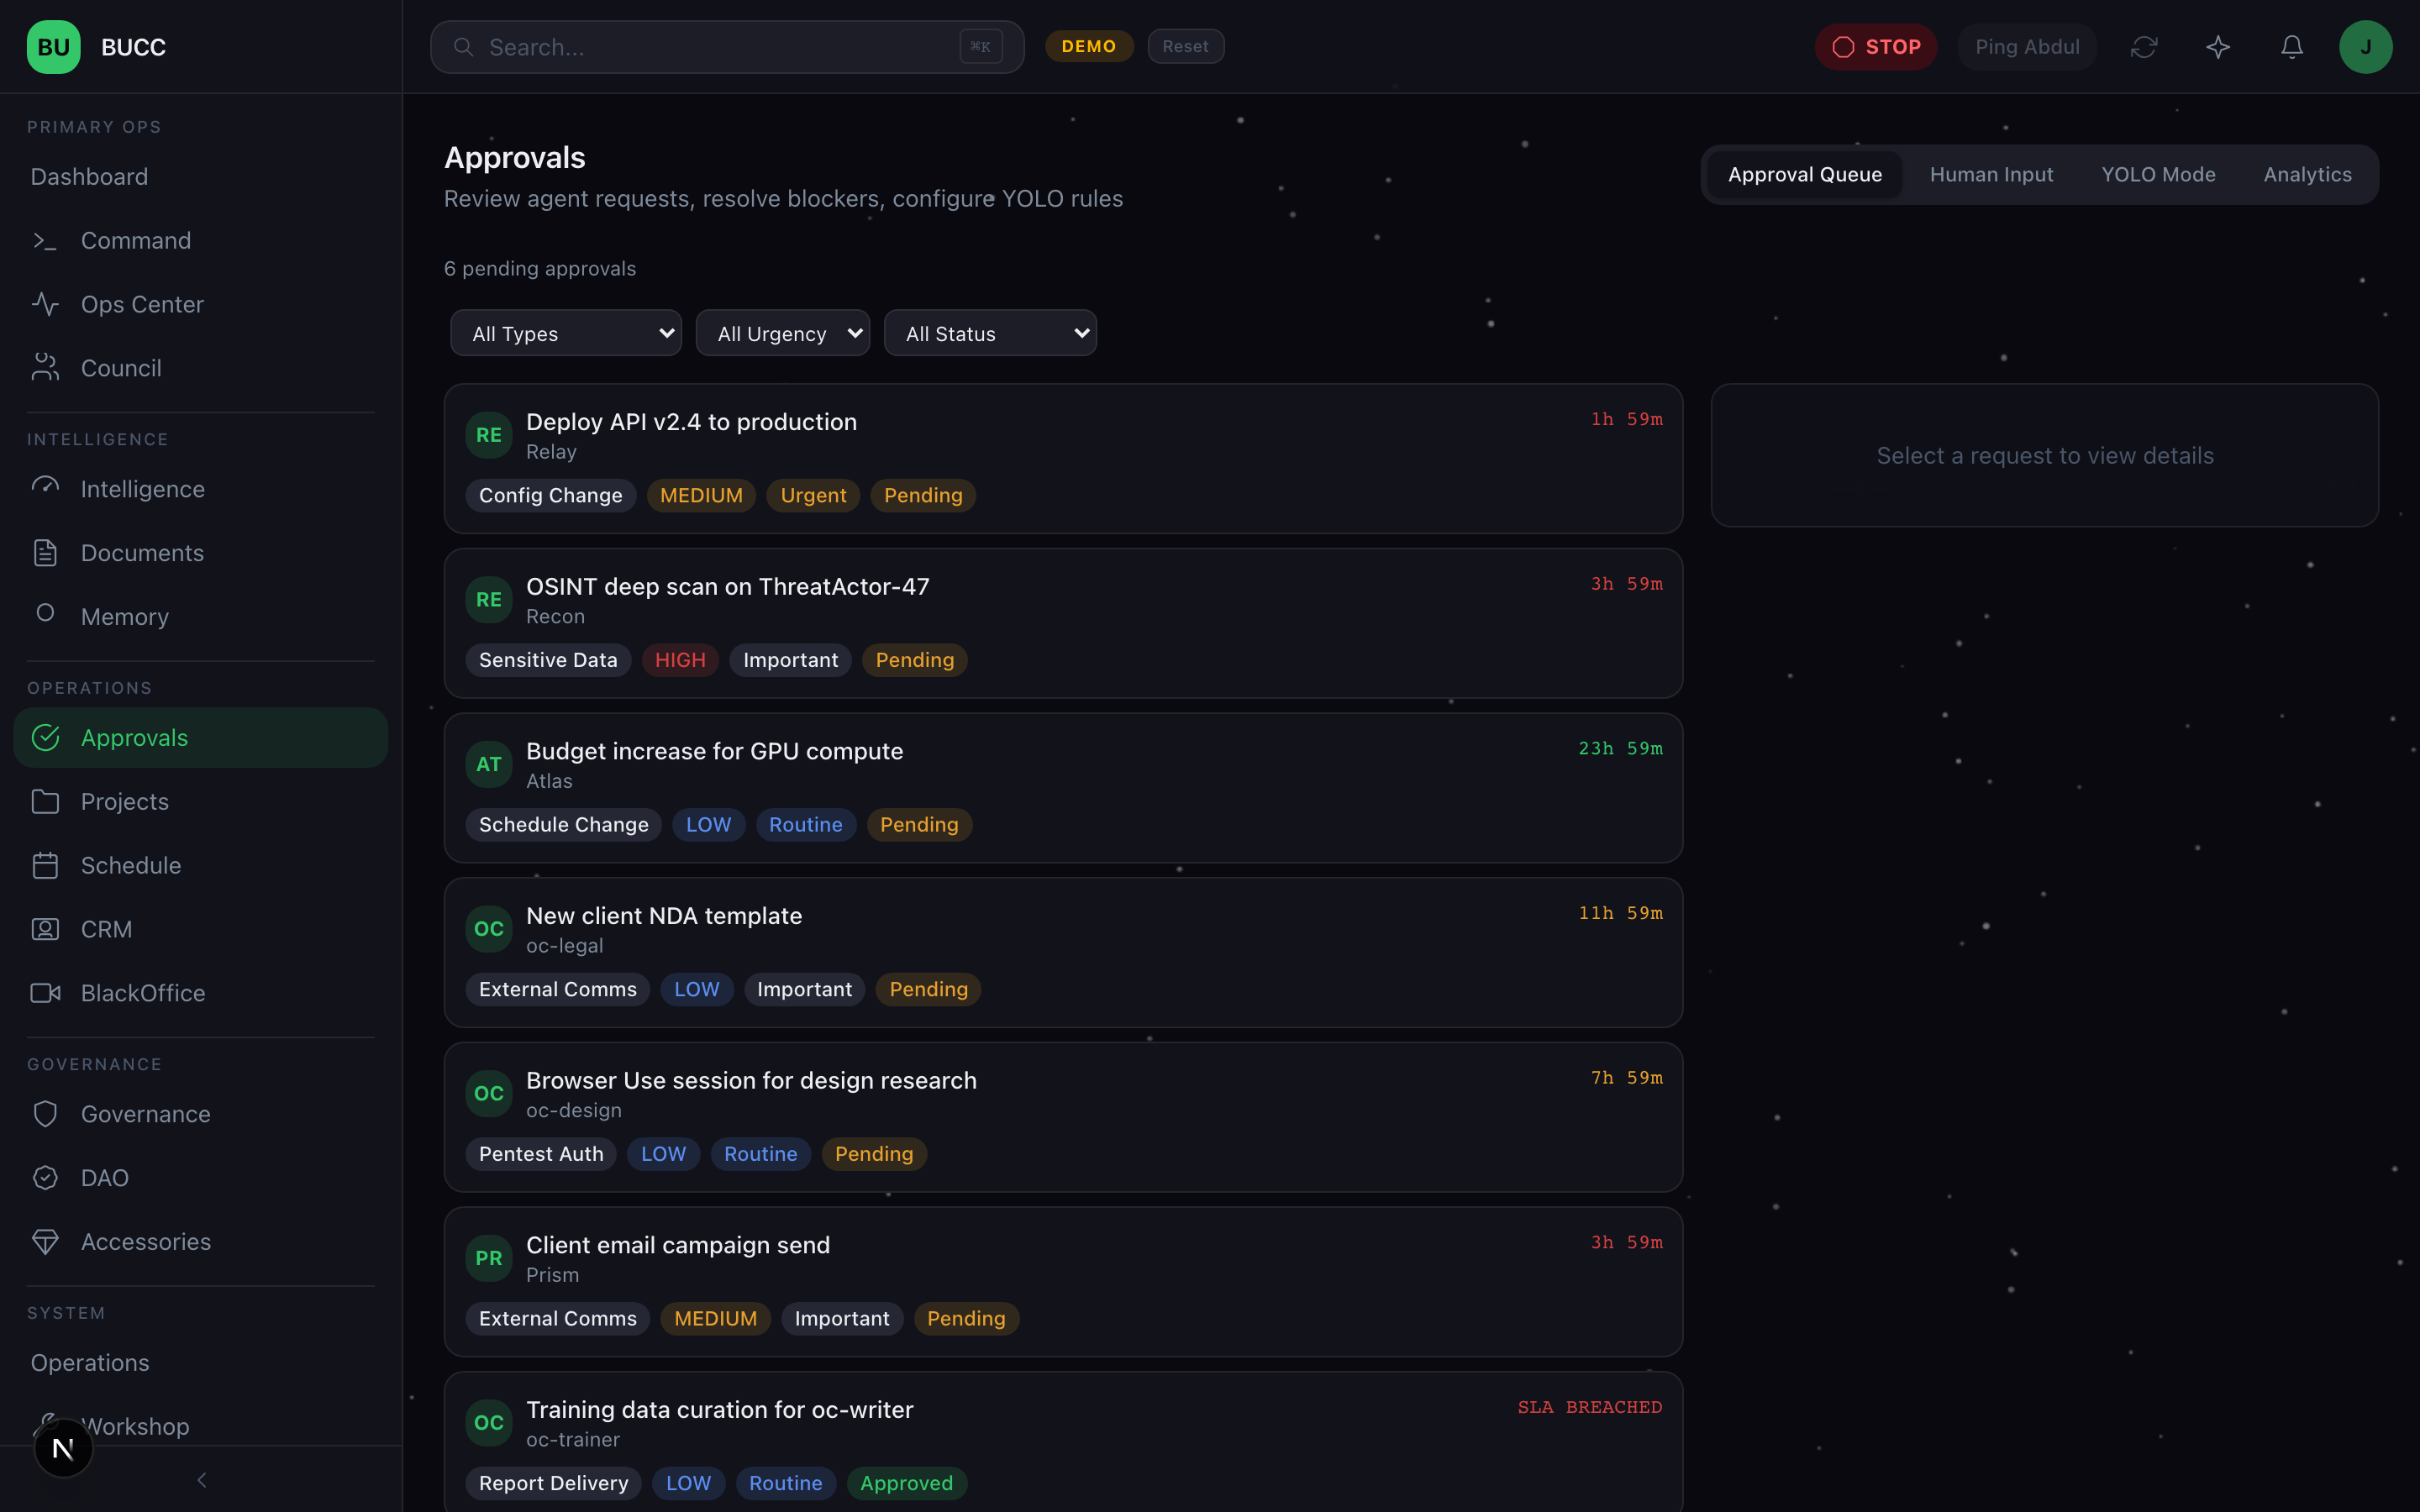
La validation humaine n'est utile que si elle arrive avec le bon contexte. Une demande d'approbation doit expliquer l'action proposée, le risque, l'agent concerné, les données utilisées et les conséquences possibles.
L'objectif n'est pas de demander à un humain de deviner. L'objectif est de lui donner assez d'éléments pour décider vite et assumer la décision.
Ce qu'une demande d'approbation doit contenir
- L'agent qui demande l'action et son rôle.
- L'action exacte que l'agent veut exécuter.
- La raison de la demande et le contexte métier.
- La classification de risque et le tier appliqué.
- Les données, outils et systèmes concernés.
- Les conséquences attendues en cas d'approbation.
- Les options possibles: approuver, refuser, déléguer, commenter ou demander plus d'information.
Workflow d'approbation et SLA
Une demande T3 doit être routée vers les bons approbateurs. Elle doit avoir une priorité, un délai, une trace de décision et un mécanisme d'escalade.
Les SLA évitent que les files d'approbation deviennent un trou noir. Si une décision critique dépasse son délai, le système doit alerter, escalader ou maintenir le blocage.
YOLO mode: confiance contrôlée
Un mode de confiance contrôlée peut être utile dans certains contextes, mais il doit rester limité. Il ne doit pas devenir une porte arrière permanente qui contourne la gouvernance.
La bonne approche consiste à le borner par agent, par type d'action, par durée et par niveau de risque. Même en mode plus autonome, l'audit doit rester complet.
Métriques d'approbation
- Nombre de demandes par tier et par agent.
- Taux d'approbation, de refus et de délégation.
- Temps moyen avant décision.
- Demandes expirées ou hors SLA.
- Actions reclassées après revue humaine.
- Évolution de la charge de validation dans le temps.
Shadow AI: la menace silencieuse
Le shadow AI apparaît quand des agents, outils ou utilisateurs appellent des modèles non autorisés, hors cadre de sécurité, hors budget ou hors audit.
Dans une flotte agentique, ce risque est plus sérieux: un agent peut découvrir un service, réutiliser une clé, contourner un chemin prévu ou transmettre des données à un fournisseur non validé.
Comment détecter le shadow AI
- Surveiller les appels réseau vers des fournisseurs LLM non autorisés.
- Contrôler les clés API et leur usage réel.
- Analyser les logs d'outils, d'automatisation navigateur et de proxy.
- Comparer les appels observés aux allowlists par agent.
- Créer des alertes quand un agent sort de son périmètre.
Exemples de signaux d'alerte
- Un agent de recherche appelle un modèle interdit au lieu du routeur officiel.
- Un outil externe transmet une donnée sensible à un service non approuvé.
- Une automatisation navigateur visite un domaine hors allowlist.
- Une hausse de coûts apparaît sans tâche associée dans la plateforme.
- Un agent utilise une capacité qui n'a jamais été provisionnée.
Fire drills: tester la gouvernance
Un contrôle non testé est une hypothèse. Les fire drills servent à vérifier que les coupe-circuits, files d'approbation, alertes et procédures fonctionnent avant une crise réelle.
Ces tests doivent être réguliers, documentés et suivis d'actions correctives.
- Simuler une action T3 et vérifier son blocage.
- Déclencher un hard stop contrôlé et vérifier l'arrêt de la flotte.
- Tester une pause financière ou communication.
- Mesurer les délais de réaction humains.
- Contrôler que les journaux contiennent le contexte attendu.
- Identifier les angles morts et mettre à jour les règles.
Ce que les tests révèlent
Les tests montrent souvent que les règles existent, mais que les personnes ne savent pas toujours quoi faire. Ils révèlent aussi les demandes trop vagues, les approbateurs mal routés, les seuils trop bas ou trop élevés, et les logs insuffisants.
C'est précisément leur intérêt: trouver les défauts de gouvernance quand l'environnement est contrôlé.
Alignement AIMS
La gouvernance décrite s'aligne avec les grands principes de management de l'IA: transparence, responsabilité, supervision, tests et adaptabilité.
- Transparence: décisions journalisées, contexte conservé, piste d'audit complète.
- Responsabilité: action attribuée à un agent et approbation attribuée à un humain.
- Supervision: tableaux de bord, files d'approbation et humain dans la boucle.
- Tests: fire drills, surveillance et détection shadow AI.
- Adaptabilité: tiers configurables, seuils dynamiques et coupe-circuits.
Dette de contrôle: mesurer l'écart de gouvernance
La dette de contrôle est l'équivalent de la dette technique appliquée à la gouvernance. Elle mesure le risque accumulé quand les contrôles vieillissent, que les décisions restent en attente ou que les règles ne correspondent plus aux usages réels.
Un score de dette permet de rendre visible ce qui resterait autrement diffus: des tests en retard, des approbations hors SLA, des alertes non traitées ou des coupe-circuits jamais vérifiés.
- 0-20: gouvernance saine, à jour et testée.
- 20-40: dette maîtrisable, sans urgence immédiate.
- 40-60: lacunes visibles à corriger rapidement.
- 60-80: niveau dangereux, risque significatif.
- 80-100: niveau critique, action immédiate nécessaire.
Ce qui augmente ou réduit la dette de contrôle
- Augmente: fire drills trop anciens, décisions T3 hors SLA, alertes shadow AI non investiguées, coupe-circuits non testés, métriques d'approbation qui se dégradent.
- Réduit: tests réalisés, approbations clôturées, alertes investiguées, coupe-circuits vérifiés, amélioration mesurable de la vitesse de décision.
Notes d'implémentation
- Commencer par T1/T2/T3: plus de niveaux ajoute de la complexité sans forcément améliorer la sécurité.
- Rendre les tiers configurables: par agent, période, état opérationnel et risque.
- Tout journaliser: la piste d'audit est le socle réel de la gouvernance.
- Automatiser les escalades: un SLA non surveillé n'est pas un contrôle.
- Tester les systèmes de sécurité: les fire drills doivent être récurrents.
- Rendre l'arrêt d'urgence accessible: un clic, visible, testé.
- Concevoir la transparence comme une fonctionnalité centrale, pas comme un reporting après coup.
Conclusion: la gouvernance est une architecture
La leçon principale est simple: la gouvernance n'est pas une fonctionnalité ajoutée à la fin. C'est une décision d'architecture.
Il faut décider très tôt quelles décisions sont réservées aux agents, lesquelles exigent une supervision humaine, comment fonctionnent les escalades et comment l'organisation reprend la main.
Les agents peuvent penser vite et traiter beaucoup d'informations. Mais la supervision humaine, les coupe-circuits et l'audit sont ce qui rend le système fiable à grande échelle.
Standards à garder en tête
- NIST AI RMF, fonction GOVERN: responsabilité, rôles et processus de gestion des risques IA.
- EU AI Act, article 9: système de gestion des risques pour les systèmes à haut risque.
- EU AI Act, article 14: supervision humaine effective.
- OWASP LLM08, Excessive Agency: risque d'agents qui agissent au-delà de leur périmètre.
Points clés
- Les garde-fous ne suffisent pas: une flotte d'agents exige une architecture de gouvernance.
- Trois tiers d'action permettent de concilier vitesse, visibilité et validation humaine.
- Les coupe-circuits doivent être gradués, testés et hiérarchisés.
- La file d'approbation doit donner assez de contexte pour décider vite.
- La dette de contrôle rend mesurable le risque accumulé dans la gouvernance.